TL;DR: Sharpness-Aware Minimization (SAM)에 대한 내용과 이를 Shinkage Theory간에 연결성에 대해 설명해보겠습니다.
About Generalization & Robustness in Deep Learning
최근 deep learning field에서는 robustness / generalization에 대해서 굉장히 관심을 많이 쏟고 있습니다. 아무래도 data 수 자체의 한계도 있을뿐만 아니라 given data 자체도 굉장히 noisy한 경우가 많기 때문에, 딥러닝 학습 때 이를 모두 완벽히 preprocessing해서 학습에 투입시키기에는 무리가 있습니다. 설사 그렇게 preprocessing을 거쳐서 좋은 quality의 data를 통해 학습을 시켰다 하더라도 실제세계에서 application으로 활용을 할 때, 좋은 quality의 data가 담보되기 어렵습니다. 그렇다보니 model의 robustness / generalization 성능을 높이기 위한 방법이 많이 연구돼왔는데 그 중 하나가 Sharpness-Aware Minimization (SAM) 입니다. 그렇다면 과연 SAM이 어떤 지점에서 generalization / robustness 와 연결이 되는지 한번 살펴보도록 하겠습니다.
Deep learning model is overparameterized.
그 전에 이제 딥러닝 모델과 그의 학습에 관하여 좀 더 살펴볼 필요가 있습니다. 우리가 “딥러닝 모델을 학습한다”라고 했을 때, 이는 어떤 문제의 최적의 해(solution)에 대한 매개변수(parameter)조합을 찾는 것입니다. 좀 더 엄밀하게 얘기를 하면 모델이란 어떤 함수 역할을 하게 되고, 이 함수를 결정하는 요소가 parameter $\theta \in \mathbb{R}^d$ 이게 되고, 이를 수식으로 표현하면 $\hat{y}=f(x;\theta)$ 입니다. 즉, 이 $d$ 개 parameter를 지니고 있는 $\theta$ 의 최적의 조합을 찾는 과정이라고 생각할 수 있을 것 같습니다.
그런데 생각을 해보면 우리가 원하는 최적의 해에 대한 parameter 조합이 딱 1개만 있을리는 없을 것입니다. 더군다나 요즘 논문들 실험에서 기본으로 사용하는 ResNet-18 모델만 하더라도 parameter 수가 굉장히 많습니다. (약 11.7M) 즉, 이러한 모델의 overparameterization 특성으로 인해 training loss를 최소화 할 수 있는 또는 최적의 해를 도출하는 parameter 조합은 무수히 많이 나올 것입니다. 이제 여기서 overfitting이 문제가 됩니다. 물론 overparameterization 특성을 다룬 [1][2]논문처럼 꼭 우리가 평소 생각하는 경향성이 나타나지 않을수도 있겠지만 (e.g., double descent) 대체적으로는 overparameterized된 모델을 꽤 오래 학습을 했을 때 ovefitting 문제가 발생하곤 합니다. 이유를 생각해보자면 학습을 할 때 보통은 deterministic(e.g., Maximum Likelihood)하게 하고, 모델 입장에서는 주어진 데이터에 대해 마치 정답을 외우다시피 한다고 볼 수 있습니다. 즉, 정답을 외웠다는 것은 어떻게 보면 주어진 문제를 한가지 방법으로만 문제를 풀 줄 안다는 얘기로 볼 수 있고 문제의 패턴 등이 조금이라도 바뀌게 된다면 틀릴 가능성이 매우 높다고 볼 수 있습니다.
(보통 이런 경우를 overfitting 됐다 또는 generalization / robustness 성능이 떨어졌다고 표현합니다.)
How to improve generalization / robustness performance?
그렇다면 이런 overfitting문제를 해결하는 방법 또는 generalization/robustness 성능을 향상시킬 수 있는 방법에 대해 생각을 해보면, 최종적으로는 input data가 조금 noisy해져도 최종 output이 유지되면 됩니다. 그러면 이제 2가지 경우를 다음과 같이 생각해볼 수 있습니다.
- 주어진 데이터의 수를 많이 늘려서 학습할 수 있는 capacity를 늘린다.
- 모델 자체를 input 변화에 robust하게 만든다
여기서 1번 같은 경우는 결국에는 학습하는 양 자체를 늘려서 케이스를 다양하게 보는 경우(e.g., Data Augmentation)입니다. 그리고 이제 두번째가 모델이 input 등에 대해서 미세한 변화가 있더라도 원하는 ouput을 내뱉는 경우입니다. 이런 robust한 모델을 만드는 방법 중 하나가 Sharpness-Aware Minimization (SAM)[3]입니다. 그래서 이번 블로그 포스팅에서 SAM에 대해서 한번 살펴보도록 하겠습니다.
What is Sharpness-Aware Minimization (SAM)?
Sharp Minima & Flat Minima
바로 이전 section에서 말씀드린 것처럼 SAM은 최종적으로 robust한 모델을 만드는 것인데, 이를 loss landscape 관점에서 접근하게 됩니다. 보통 모델의 학습을 판단할 수 있는 근거는 사실 loss가 전부라고 해도 무방합니다. 그런 관점에서 보면 이 모델의 behavior 하나는 loss landscape을 그려보는 것입니다. 아래 그림을 보면서 설명드리도록 하겠습니다.
(Loss landscape에 대한 자세한 내용은 해당 논문 [4]를 참고해주세요!!)
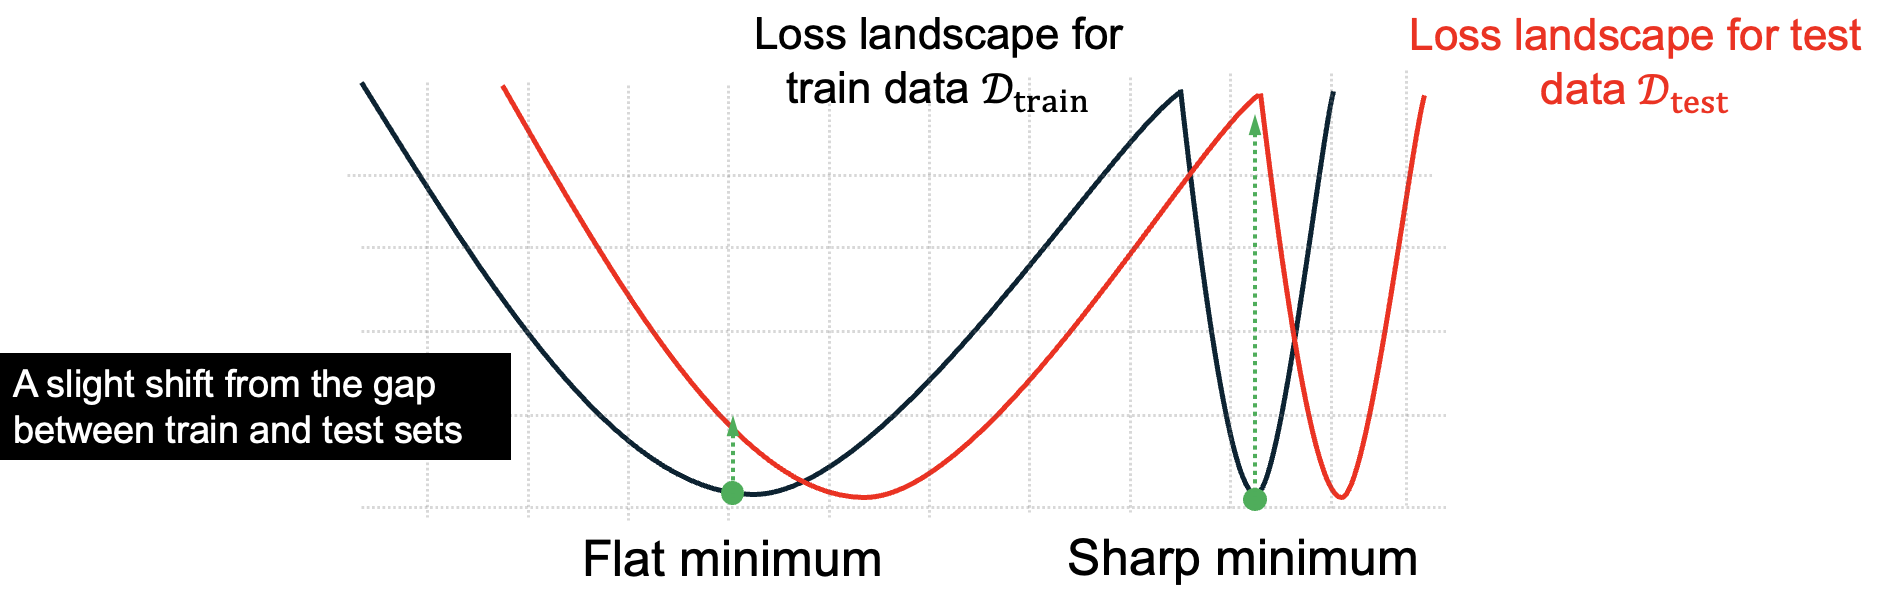 |
보시면 loss landscape이 flat했을 때 sharp 했을 때 어떤 특성을 띄는지 볼 수 있습니다. 만약 모델이 형성하는 loss landscape이 sharp하다면 데이터 분포(data distribution)이 조금만 달라져도 급격이 loss가 커지게 됩니다. 그런데 만약 loss landscape이 flat하다면 data distribution이 조금 달라지더라도 loss 값의 변화가 sharp minima만큼 변화하진 않습니다. 따라서, “loss landscape을 flat하게 만들 수 있다면 더 robust한 모델을 만들 수 있다!”라는 관점을 제시할 수 있습니다. SAM은 이런 관점으로부터 시작을 합니다.
Sharpness-Aware Minimization (SAM)
SAM이 어떻게 loss landscape을 flat하게 만드는지를 이해하기 위해, 먼저 일반적인 모델 학습과 비교해 보겠습니다. 일반적인 학습에서는 현재 모델의 parameter에서 loss를 최소화하는 방향으로 학습을 진행합니다. 반면, SAM은 현재 parameter 주변에서 loss가 가장 크게 증가하는 지점(worst-case)을 먼저 찾고, 해당 지점에서의 loss를 최소화하는 방향으로 학습을 진행합니다. 즉, 단순히 현재 parameter에서 낮은 loss를 갖는 것이 아니라, parameter가 조금 변화하더라도 loss가 크게 증가하지 않도록 학습하는 것입니다. 이러한 접근을 통해 SAM은 주변 변화에 상대적으로 robust한, 보다 flat한 loss landscape을 형성하고자 합니다. 이를 수식으로 표현하면 다음과 같습니다.
\[\textcolor{blue}{\min_{\theta}}\textcolor{red}{\max_{|\epsilon|_2\leq\rho}}\mathcal{L}(\theta+\epsilon)\]여기서 $\theta$는 모델의 parameter, $\mathcal{L}$은 loss function, $\epsilon$은 parameter perturbation을 의미하며, $\rho$는 perturbation의 크기를 제한하는 radius를 나타냅니다. 위 수식에서 주목해야 할 부분은 inner maximization과 outer minimization입니다:
Inner Maximization: parameter $\theta$를 중심으로 반경 $\rho$ 이내에서 loss가 가장 크게 증가하는 perturbation $\epsilon$을 찾는 과정Outer Minimization: 해당 perturbation이 적용된 지점에서의 loss를 최소화하도록 parameter를 update
즉, SAM은 현재 parameter에서의 loss뿐만 아니라 그 주변에서 발생할 수 있는 worst-case loss까지 고려함으로써, 보다 flat한 loss landscape을 갖는 해를 찾도록 유도합니다. 이를 좀 더 쉽게 설명하면 loss가 증가하는 방향에 대해서 꾹꾹 눌러주면서 학습을 진행한다고 보시면 되겠습니다.
그렇다면 구체적으로 inner maximization과 outer minimization을 어떻게 계산하는지 살펴보겠습니다.
Inner Maximization
위에서 설명한 바를 보면 inner maximization은 현재 $\theta$를 중심으로 반경 $\rho$ 이내에서 loss가 가장 크게 증가하는 perturbation $\epsilon$을 찾는 과정이라고 했습니다. 그런데 생각해보면 모든 perturbation을 하나하나 적용해 보면서 loss가 가장 크게 증가하는 지점을 찾는 것은 현실적으로 불가능합니다. 특히 deep learning에서는 모델의 parameter 수가 굉장히 많기 때문에, 가능한 모든 방향을 탐색하기에는 상당한 computational cost가 발생하게 됩니다.
모든 perturbation 반경 $|\epsilon|_2 \leq \rho$에 대해 grid search를 하지 않고도 찾는 방법을 생각해보자면 공학의 묘미 중 하나인 근사를 해주면 됩니다. 그리고 SAM 논문은 이를 Taylor Expansion을 이용하여 loss function을 근사합니다. 그러면 우선 Taylor Expansion으로 근사하기 전에, 원 식을 살펴보면 다음과 같습니다.
여기서 $H(\theta)=\nabla_\theta^2\mathcal{L}(\theta)$는 Hessian matrix를 의미하며, loss function의 curvature를 나타냅니다. 쉽게 설명하면, First-order term은 현재 parameter에서 loss가 어느 방향으로 증가하는지를 나타내고, Second-order term은 해당 방향에서 loss가 얼마나 급격하게 변화하는지를 나타냅니다. 하지만 Hessian까지 고려해서 계산을 하게되면 outer minimization을 하기도 전에 complexity가 제곱으로 늘어나기 떄문에, SAM에서는 이를 생략하고 First-order term만 사용합니다.
(SAM 논문에서 Hessian까지 넣어서 실험을 하긴 했는데 아주 유의미한 성능 개선이 보이진 않았습니다.)
\[\mathcal{L}(\theta+\epsilon) \approx \mathcal{L}(\theta) + \nabla_\theta\mathcal{L}(\theta)^\top\epsilon\]그러면 이제 여기서 확인해야 할 부분은 어떻게 최적의 perturbation $\epsilon$을 찾을 수 있는가입니다. 앞서 $\rho$는 perturbation의 범위를 정해주는 일종의 hyperparameter라고 설명드렸습니다. 그렇다면 우리가 찾아야 하는 것은 반경 $\rho$ 이내에서 loss를 가장 크게 증가시키는 perturbation $\epsilon$이 됩니다. 이를 좀 더 풀어서 설명하면, $\rho$를 통해 perturbation의 범위를 정해두었다고 하더라도, 그 안에서 loss가 모든 방향으로 동일하게 증가하는 것은 아닙니다. 어떤 방향으로 perturbation을 적용하느냐에 따라 loss가 크게 증가할 수도 있고, 상대적으로 적게 증가할 수도 있습니다. 따라서 수많은 방향 중에서 어떤 perturbation을 적용해야 loss가 가장 크게 증가하는지를 직접 알아내기는 쉽지 않습니다. 그렇기 때문에 SAM에서는 앞서 설명한 First-order Taylor Approximation을 이용하여 worst-case perturbation을 근사하게 됩니다. 이를 다음과 같은 수식으로 나타내면:
\[\begin{aligned} \epsilon^{\ast} &= \arg\max_{\|\epsilon\|_2\leq\rho} \mathcal{L}(\theta+\epsilon) \\ &\approx \arg\max_{\|\epsilon\|_2\leq\rho} \nabla_\theta\mathcal{L}(\theta)^\top\epsilon + \underbrace{\cancel{\mathcal{L}(\theta)}}_{\epsilon \text{과 관계없음}} \end{aligned}\]따라서 이제 우리가 찾아야 하는 것은 gradient와 perturbation의 내적을 최대화하는 $\epsilon$이 됩니다. 그런데 여기서도 문제가 있는데, Gradient는 이미 계산되어 있지만 어떤 방향과 크기의 perturbation을 적용해야 내적이 최대가 되는지는 아직 알 수 없습니다.
이를 해결하기 위해 Cauchy–Schwarz Inequality를 적용하면 다음과 같은 관계를 얻을 수 있습니다.
즉, 앞에서 $\rho$를 통해 $\epsilon$의 크기는 최대 $\rho$가 되고, 이에 대한 upper bound로 표현할 수 있습니다. 그렇다면 이제 남은 것은 어떤 방향으로 perturbation을 적용해야 loss가 가장 크게 증가할 수 있는지를 찾는 것입니다. 여기서 gradient는 기본적으로 loss가 가장 빠르게 증가하는 방향을 나타냅니다. 따라서 gradient가 0이 아니라면, $\epsilon$을 gradient와 동일한 방향으로 설정하고 그 크기를 $\rho$로 맞췄을 때 위 식의 최댓값을 얻을 수 있습니다. 이를 수식으로 나타내면 다음과 같습니다.
\[\boxed{\hat{\epsilon}=\rho\frac{\nabla_\theta\mathcal{L}(\theta)}{\|\nabla_\theta\mathcal{L}(\theta)\|_2}}\]즉, gradient를 정규화하여 방향은 유지하되, perturbation의 크기를 $\rho$에 맞춰주는 것입니다. 이렇게 하면 앞서 First-order Taylor Expansion으로 근사한 loss function에서 가장 큰 loss 증가를 유도하는 perturbation을 구할 수 있게 됩니다.
결국 SAM에서는 모든 perturbation을 직접 탐색하는 대신, 현재 gradient를 이용하여 worst-case perturbation을 근사하는 것입니다. 물론 이조차 근사치이기 때문에 구한 $\hat{\epsilon}$이 항상 정확한 worst-case perturbation이라고 보장할 수는 없습니다. 하지만 한 번의 gradient 계산만으로 inner maximization을 효율적으로 수행할 수 있게 됩니다.
(항상 trade-off는 존재하기 때문에… + 그리고 위에서 말한대로 논문에서 실험적으로도 차이가 적음을 보였기 때문에…)
Outer Minimization
그 다음으로는 이제 해당 perturbation이 적용된 지점에서의 loss를 최소화하는 것입니다. 해당 process는 사실 일반적인 학습 update로 생각해주시면 됩니다. 다만, SAM에서는 앞서 구한 $\hat{\epsilon}$을 현재 parameter에 적용한 뒤, $\theta+\hat{\epsilon}$에서의 gradient를 계산하여 parameter를 update하게 됩니다. 즉, perturbation을 준 위치에서 update를 진행하게 된다고 이해해주시면 됩니다. 따라서 gradient update을 할 loss는 $\mathcal{L}_{\mathrm{SAM}}(\theta)\approx\mathcal{L}(\theta+\hat{\epsilon})$ 가 됩니다.
그런데 여기서 한 가지 확인해야 할 부분이 있습니다. 사실, $\hat{\epsilon}$은 현재 parameter $\theta$의 gradient를 이용하여 계산했기 때문에, $\hat{\epsilon}$ 역시 $\theta$에 의존하는 값입니다. 따라서 이를 $\theta$에 대해 미분하게 되면 Chain Rule에 의해 추가적인 derivative term이 발생하고, 이 과정에서 Hessian을 포함하는 Second-order computation이 필요하게 됩니다. 하지만 SAM에서는 computational cost를 줄이기 위해 $\hat{\epsilon}$을 고정된 값으로 취급하여 해당 term을 생략합니다. 따라서 최종적인 gradient는 다음과 같이 근사할 수 있습니다.
\[\boxed{\nabla_\theta\mathcal{L}_{\mathrm{SAM}}(\theta)\approx\nabla_\phi\mathcal{L}(\phi)\big|_{\phi=\theta+\hat{\epsilon}(\theta)}}\]즉, 복잡한 Second-order computation을 수행하는 대신 perturbation이 적용된 지점에서 gradient를 한 번 더 계산하는 것입니다. 이렇게 구한 gradient를 이용하여 최종적으로 parameter를 update하면 다음과 같습니다.
\[\boxed{\theta_{t+1}=\theta_t-\eta\nabla_\phi\mathcal{L}(\phi)\big|_{\phi=\theta_t+\hat{\epsilon}_t}}\]여기서 $\eta$는 learning rate를 의미합니다. 주목해야 할 점은 gradient는 perturbation이 적용된 지점에서 계산하지만, 실제 parameter update는 원래의 $\theta_t$를 기준으로 진행한다는 것입니다. 이를 좀 더 풀어서 설명하면, SAM에서는 먼저 loss가 가장 크게 증가할 것으로 예상되는 지점으로 이동한 뒤, 그 지점에서 loss를 감소시키는 방향을 계산하고 이를 원래 parameter에 적용하는 것입니다.
결국 SAM은 Inner Maximization을 통해 loss가 크게 증가하는 방향을 찾고, Outer Minimization을 통해 해당 지점에서의 loss를 줄이는 방향으로 학습을 진행합니다. 앞에서 설명드렸던 것처럼 loss landscape에서 sharp하게 튀어나온 부분을 꾹꾹 눌러주는 것과 비슷하다고 생각하시면 되겠습니다. 다만, 이러한 과정에서는 inner maximization과 outer minimization 각각 gradient를 계산해야 하므로, 일반적인 학습에 비해 약 2배의 gradient computation이 필요하다는 특징이 있습니다.
총 정리
다시 한번 총 정리를 해보면 SAM의 기작은 다음과 같습니다.
-
Loss Landscape 관점에서 flatter minima를 찾도록 학습하여 모델의 robustness/generalization 성능을 개선
-
학습 과정:-
\[\hat{\epsilon}_t=\rho\frac{\nabla_\theta\mathcal{L}(\theta_t)}{\|\nabla_\theta\mathcal{L}(\theta_t)\|_2}\]Gradient 계산: 현재 parameter $\theta_t$에서 gradient를 계산하고, 이를 이용하여 worst-case perturbation $\hat{\epsilon}_t$을 근사 -
Perturbed Gradient 계산: 앞서 계산한 perturbation을 parameter에 적용 및 해당 지점에서 gradient를 다시 계산 $\Rightarrow$ $\nabla_\phi\mathcal{L}(\phi)$ where ${\phi=\theta_t+\hat{\epsilon}_t}$ -
\[\theta_{t+1}=\theta_t-\eta\nabla_\phi\mathcal{L}(\phi)\big|_{\phi=\theta_t+\hat{\epsilon}_t}\]Parameter Update: 최종적으로 계산한 gradient를 이용하여 원래 parameter $\theta_t$를 update
-
-
즉, 현재 parameter에서 loss가 가장 크게 증가하는 방향을 먼저 찾고, 해당 지점에서 loss를 줄이는 방향으로 학습
-
다만 이러한 과정에서 gradient를 두 번 계산해야 하므로, 일반적인 SGD에 비해 약 2배의 gradient computation이 필요하다는 단점 존재
이후 SAM을 기반의 다양한 variants들이 나왔습니다. 대표적으로 몇 가지만 소개드리면:
Adaptive SAM (ASAM)[5]: 기존 SAM이 parameter의 scale을 충분히 고려하지 못하는 문제를 개선하기 위해, parameter scale에 따라 perturbation 범위를 adaptive하게 조절Surrogate Gap SAM (GSAM)[6]: 기존 SAM의 perturbed loss minimization만으로는 충분한 flatness를 확보하기 어려울 수 있다는 점을 고려하여, surrogate gap을 추가적으로 줄이도록 학습Efficient SAM (ESAM)[7]: SAM의 computational cost를 줄이기 위해 일부 weight에만 perturbation을 적용하고, sharpness에 민감한 data를 선택적으로 활용Bayesian SAM (BayesianSAM)[8]: SAM을 Bayesian 관점에서 재해석하고, parameter별 uncertainty를 고려하여 perturbation을 조절LookSAM[9]: 이전 iteration에서 계산한 SAM gradient 정보를 재사용하고, SAM update의 계산 빈도를 줄여 computational cost를 개선
이처럼 SAM이 처음 제안된 이후에는 어떻게 하면 loss landscape을 더 flat하게 만들 수 있을지, 또는 어떻게 하면 computational cost를 줄이면서도 비슷한 성능을 얻을 수 있을지에 대한 다양한 연구가 진행되었습니다. 그렇게 SAM 계열 연구진행이 되다가, 최근에는 “Loss landscape을 flat하게 만드는 것이 다른 learning approach에서도 효과적일까?”라는 관점에서도 많은 연구가 이루어지고 있습니다. 대표적으로 저희 연구실에서도 Reinforcement Learning [10], Generative Model [11] 등에 SAM을 적용했을 때 어떤 behavior를 보이는지 연구해 왔으며, 이 외에도 다양한 분야에서 loss landscape flatness에 대한 연구를 진행하고 있습니다.
Link to Shrinkage Theory
제가 SAM 관련 연구를 쭉 하다가 어떤 대가분과 discussion 할 기회가 생겼는데, 그분께서 SAM을 보시더니 “이거 딱 보니까 Shrinkage Theory / Method와 상당히 유사해 보이는데?”라는 말씀을 툭 던지셨습니다. 그래서 저도 곰곰이 생각을 하고 LLM과 대화를 좀 해보니 개념적으로 유사한 부분이 있다는 생각이 들었습니다. 물론, 논문화로 이어지기엔 novelty 측면에서 조금 부족할 수 있지만, 블로그에 남겨두면 좋지 않을까 싶었습니다. 그래서 이번 section에서는 아주 엄밀한 이론적 연결은 아니지만, SAM과 Shrinkage Theory 사이에 어떤 연결지점들이 있는지 같이 살펴보도록 하겠습니다!! (처음 Muon도 블로그 포스팅으로 시작했듯이… 이 역시 언젠가 논문화 되지 않을까 기대합니다…!!)
SAM in Hessian Perspective
이제까지 SAM에 대해서 조금 technical하고 insightful하게 살펴보았습니다. 그런데 사실 이걸 다시 바꿔 생각을 해보면 결국엔 machine learning에서 제일 기초로 배우는 convexity와 loss curvature로 연결됩니다. 즉, 결국 loss landscape의 특성을 결정하는 요소 중 하나인 Hessian의 특성으로 귀결됩니다. 물론, 실제 SAM 학습 때는 Hessian term을 학습에 직접 참여시키진 않았지만 SAM이 최종적으로 찾고자 하는 것이 flat한 loss landscape이라는 점을 생각해 보면, Hessian을 통해 SAM이 loss curvature와 어떤 관계를 가지는지 분석할 수 있습니다.
(실제로 Hessian을 근사한 Fisher Information Matrix (FIM)을 활용하는 FisherSAM method도 존재합니다.)
이를 좀 더 직접적으로 살펴보면 SAM의 objective function을 다음과 같이 나타낼 수 있습니다:
\[\mathcal{L}(\theta+\epsilon)\approx\mathcal{L}(\theta)+\nabla_\theta\mathcal{L}(\theta)^\top\epsilon+\frac{1}{2}\epsilon^\top H(\theta)\epsilon\]그런데 여기서 한 가지 가정을 해보겠습니다. 현재 parameter $\theta^\ast$가 local minimum에 위치한다고 생각하면, 해당 지점에서는 $\nabla_ \theta\mathcal{L}(\theta^\ast)=0$이 됩니다. 따라서 First-order term이 사라지게 되고, loss function은 다음과 같이 근사할 수 있습니다:
\[\mathcal{L}(\theta^{\ast}+\epsilon)\approx\mathcal{L}(\theta^{\ast})+\frac{1}{2}\epsilon^\top H(\theta^{\ast})\epsilon\]이 의미인 즉슨, local minimum 주변에서 loss가 얼마나 증가하는지는 Hessian의 특성에 의해 결정되는 것입니다. 그렇다면 이제 여기서 Hessian 분석을 통해 실제 loss landscape의 형태와 어떤 관계를 가지는지를 살펴보겠습니다.
Hessian은 $(N \times N)$ matrix (또는 symmetric matrix)이기 때문에 eigendecomposition으로 표현이 가능합니다.
\[H(\theta^*)=Q\Lambda Q^\top,\qquad \Lambda=\operatorname{diag}(\lambda_1,\ldots,\lambda_d)\]이때 중요한 점은 각 eigenvector가 loss landscape에서의 방향을 나타내고, 해당 eigenvalue는 그 방향에서의 curvature를 나타낸다는 것입니다. 쉽게 말해서 eigenvalue가 크다면 해당 방향에서 loss가 급격하게 증가하는 sharp한 형태를 보이고, 반대로 eigenvalue가 작다면 상대적으로 flat한 형태를 보이게 됩니다.
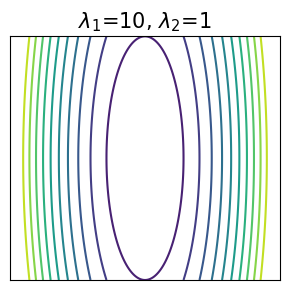
이를 좀 더 쉽게 이해하기 위해 Hessian을 2D로 생각해 보겠습니다. (아래 그림 참고) 예를 들어 두 eigenvalue가 $\lambda_1=10$, $\lambda_2=1$이라고 가정을 한다면, 한 방향으로는 loss가 급격하게 증가하는 반면 다른 방향으로는 상대적으로 천천히 증가하게 됩니다. 따라서 동일한 loss 값을 갖는 contour를 그려보면 한쪽으로 길게 늘어진 elliptical shape이 나타납니다.
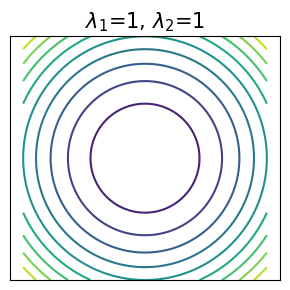
반대로 두 eigenvalue가 $\lambda_1=\lambda_2=1$으로 동일하다면 각 방향에서의 curvature도 비슷해지기 때문에, contour가 상대적으로 spherical shape에 가까워지게 됩니다.
자 그렇다면 이러한 Hessian의 특성이 SAM과의 관계를 다시 살펴볼 수 있는데, 앞에서 확인했던 Second-order 근사와 SAM의 inner maximization에 다시 적용하면 다음과 같습니다.
\[\mathcal{L}_{\mathrm{SAM}}(\theta^*)\approx\mathcal{L}(\theta^*)+\max_{\|\epsilon\|_2\leq\rho}\frac{1}{2}\epsilon^\top H(\theta^*)\epsilon\]여기서 주목할 부분은 perturbation $\epsilon$의 방향에 따라 loss의 증가량이 달라진다는 점입니다. 앞서 Hessian의 eigenvalue가 각 방향에서의 curvature를 나타낸다고 설명했습니다. 즉, eigenvalue가 큰 방향일수록 동일한 크기의 perturbation에 대해 loss가 더 크게 증가하게 됩니다. 이를 좀 더 구체적으로 살펴보겠습니다. 앞서 Hessian을 Eigendecomposition했던 것처럼, perturbation $\epsilon$ 역시 Hessian의 eigenvector들을 이용하여 표현할 수 있습니다.
\[\epsilon=\sum_{i=1}^{d}a_iq_i\]여기서 $q_i$는 Hessian의 eigenvector이고, $a_i$는 해당 eigenvector 방향으로 적용되는 perturbation의 크기를 의미합니다. 이를 Second-order term에 대입하면 다음과 같이 표현할 수 있습니다.
\[\epsilon^\top H(\theta^*)\epsilon=\sum_{i=1}^{d}\lambda_i a_i^2\]즉, perturbation에 따른 loss의 증가량은 각 방향의 eigenvalue와 해당 방향으로 적용한 perturbation의 크기에 의해 결정됩니다. 그런데 SAM에서는 perturbation의 크기를 반경 $\rho$ 이내로 제한하고 있기 때문에, 모든 방향에 무제한으로 perturbation을 적용할 수는 없습니다. 이를 수식으로 표현하면 다음과 같습니다.
\[\|\epsilon\|_2^2=\sum_{i=1}^{d}a_i^2\leq\rho^2\]따라서 주어진 perturbation 내에서 loss를 최대한 증가시키기 위해서는 가장 큰 eigenvalue를 가지는 방향으로 perturbation을 집중하는 것이 유리합니다. Eigenvalue가 클수록 해당 방향에서의 curvature가 크기 때문에, 동일한 perturbation을 적용하더라도 loss가 더 크게 증가하기 때문입니다. 이를 수식으로 정리하면 다음과 같은 upper bound를 얻을 수 있습니다.
\[\epsilon^\top H(\theta^*)\epsilon=\sum_{i=1}^{d}\lambda_i a_i^2\leq\lambda_{\max}(H(\theta^*))\sum_{i=1}^{d}a_i^2\leq\rho^2\lambda_{\max}(H(\theta^*))\]여기서 $\lambda_{\max}(H)$는 Hessian의 maximum eigenvalue를 의미합니다. 그리고 local minimum에서 Hessian이 Positive Semi-Definite (PSD)라고 가정하면, maximum eigenvalue에 해당하는 eigenvector 방향으로 크기가 $\rho$인 perturbation을 적용했을 때 위 upper bound에 도달할 수 있습니다. 따라서 앞서 살펴본 SAM의 objective를 최종적으로 다음과 같이 근사할 수 있습니다.
\[\boxed{\mathcal{L}_{\mathrm{SAM}}(\theta^*)\approx\mathcal{L}(\theta^*)+\frac{\rho^2}{2}\lambda_{\max}(H(\theta^*))}\]이를 조금 풀어서 설명해보면 SAM이 worst-case loss를 최소화한다는 것은, Second-order 관점에서는 Hessian의 maximum eigenvalue가 큰 solution에 더 큰 penalty를 거는 것과 연결됩니다.
즉, Hessian의 eigenvalue가 지나치게 큰 방향에서는 perturbation에 의해 loss가 급격하게 증가할 수 있기 때문에, SAM은 이러한 sharp한 방향의 curvature가 상대적으로 작은 solution을 선호하도록 학습한다고 볼 수 있습니다.
따라서, 특정 방향의 eigenvalue가 지나치게 크고, 이를 줄이는 방향으로 학습이 진행된다면 loss landscape의 비교적 평평해질테고 그렇게 됐을 때 위 Figure 2처럼 비교적 spherical한 형태에 가까워질것입니다.
이러한 eigenvalue의 변화를 이해하는 데 참고할 만한 개념이 통계학에도 존재하는데, 바로 Shrinkage Theory입니다.
What is Shrinkage Theory?
Shrinkage Theory
Shrinkage Theory는 통계학에서 발전한 개념으로, 간단하게 설명하자면 추정(estimate)한 값을 특정한 기준점(target)으로 축소시켜 전체적인 estimation error를 줄이는 개념이라고 생각하시면 됩니다.
이유는, 일반적으로 통계학에서는 주어진 데이터를 이용하여 unknown parameter를 추정하게 됩니다.
그런데 만약 데이터에 noise가 존재하거나 sample 수가 충분하지 않다면, 실제 값과 추정한 값 사이에 차이가 필연적으로 발생하게 됩니다.
생각해보면 실제 세계에서는 데이터가 noisy한 것이 너무 당연하고 또 데이터 sample 수를 키울 수 없기 때문에 일차적으로 할 수 있는 방법은 현재 추정한 값에서 조정을 하는 것입니다.
이때 사용되는 대표적인 개념이 바로 Shrinkage입니다.
이를 일반적인 수식으로 표현하면 다음과 같습니다.
$\hat{\theta}$는 데이터로부터 얻은 estimate, $\theta_0$는 shrinkage target, $\alpha\in[0,1]$는 shrinkage의 정도를 조절하는 coefficient 입니다.
여기서 shrinkage target은 기존 estimate를 어느 값에 가깝게 조정할 것인지를 결정하는 기준값으로, 사전에 알고 있는 정보(prior knowledge)나 전체 데이터의 평균 등을 활용하여 설정할 수 있습니다.
따라서, $\alpha=0$이면 기존 estimate를 그대로 사용하고, $\alpha=1$이면 target $\theta_0$를 사용하게 됩니다.
그 사이에서는 기존 estimate와 target을 적절히 섞어주는 것이라고 이해하시면 됩니다.
이렇게 생각하면 오히려 기존 estimate를 그대로 사용하는 것이 더 정확하지 않을까 싶지만, 통계학에서는 Shrinkage에 따르면 역설적으로 특정 target으로 이동시키는 것이 오히려 estimation의 정확도를 높일 수 있다는 점이 중요한 특징입니다.
이를 이해하기 위해서는 Bias–Variance Tradeoff[12]라는 개념을 살펴볼 필요가 있습니다.
우선 수식은 일반적으로 추정량의 Mean Squared Error (MSE)로 표현하곤 하는데 다음과 같이 나타낼 수 있습니다.
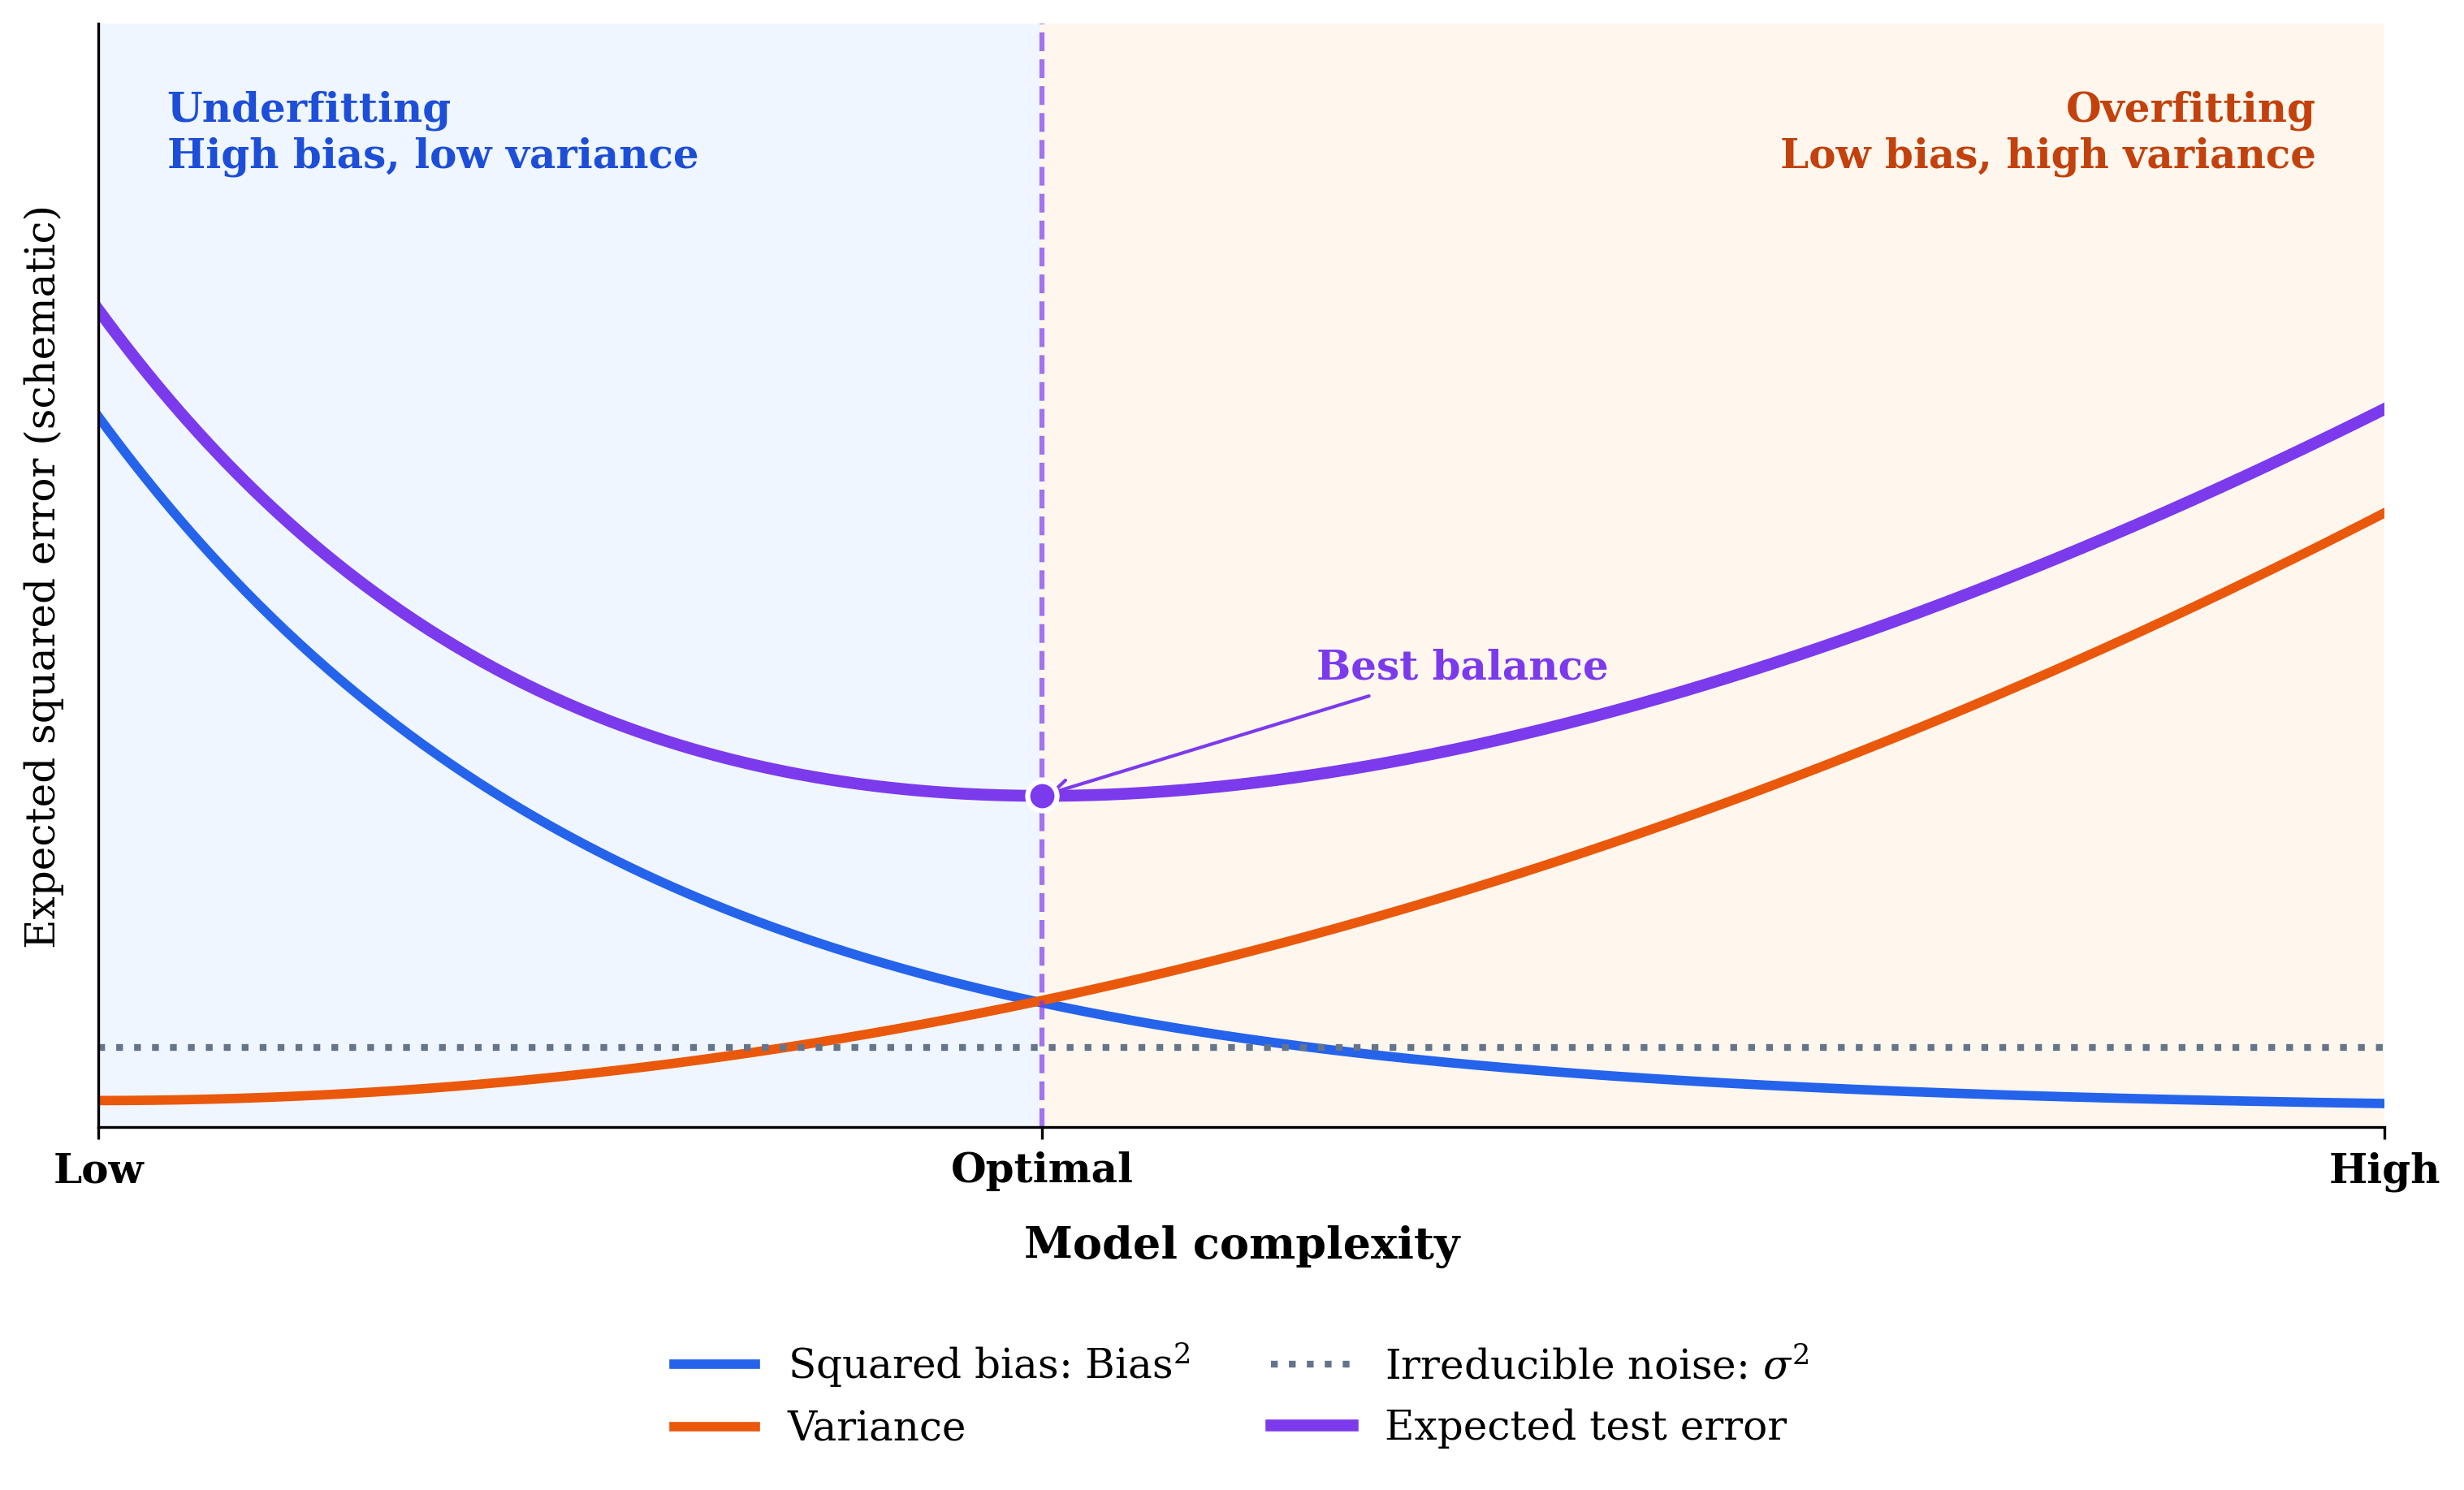
여기서 $\mathrm{Bias}(\hat{\theta})$는 추정량의 평균이 실제 값으로부터 얼마나 벗어나 있는지를 나타내고, $\mathrm{Var}(\hat{\theta})$는 데이터가 달라졌을 때 추정량이 얼마나 불안정하게 변하는지를 나타냅니다. 즉, 추정량의 정확도를 평가할 때는 실제 값과의 차이뿐만 아니라, 데이터에 따른 추정량의 변동성까지 함께 고려해야 한다는 의미입니다. 이에 대해, 아래 Figure 3을 보면 어느정도 이해하실 수 있을겁니다.
그렇다면, 이제 이를 앞서 설명한 Shrinkage에 적용해 보겠습니다. 먼저 설명을 단순화하기 위해 실제 parameter를 $\theta$라고 하고, 기존 estimate $\hat{\theta}$가 unbiased estimator (Bias=0) 라고 가정하면 다음과 같이 표현할 수 있습니다.
\[\mathbb{E}[\hat{\theta}]=\theta\]이 때 Shrinkage를 적용하면 추정량이 다음과 같이 변화하게 됩니다.
\[\hat{\theta}_{\mathrm{shrink}}=(1-\alpha)\hat{\theta}+\alpha\theta_0\]여기서 $\theta_0$와 $\alpha$가 고정된 값이라고 가정하고 expectation을 계산하면 다음과 같습니다.
\[\mathbb{E}[\hat{\theta}_{\mathrm{shrink}}]=(1-\alpha)\theta+\alpha\theta_0\]따라서 실제 parameter $\theta$와의 차이인 Bias는 다음과 같이 나타낼 수 있습니다.
\[\mathrm{Bias}(\hat{\theta}_{\mathrm{shrink}})=\mathbb{E}[\hat{\theta}_{\mathrm{shrink}}]-\theta=\alpha(\theta_0-\theta)\]즉, 기존에는 Bias가 0이었지만, Shrinkage를 적용하면서 target $\theta_0$와 실제 parameter $\theta$ 사이의 차이에 비례하는 Bias가 발생하게 됩니다. 하지만 여기서 중요한 것은 Variance입니다. 동일한 방식으로 Shrinkage가 적용된 estimate의 Variance를 계산하면 다음과 같습니다.
\[\mathrm{Var}(\hat{\theta}_{\mathrm{shrink}})=(1-\alpha)^2\mathrm{Var}(\hat{\theta})\]앞서 $\alpha\in[0,1]$라고 정의했기 때문에 $(1-\alpha)^2\leq1$이 성립합니다. 따라서 Shrinkage를 적용하면 기존 estimate의 Variance가 감소하거나 동일하게 유지됩니다. 이제 이 두 결과를 앞서 설명한 MSE에 다시 적용하면 다음과 같습니다.
\[\boxed{\mathrm{MSE}(\hat{\theta}_{\mathrm{shrink}})=\alpha^2(\theta_0-\theta)^2+(1-\alpha)^2\mathrm{Var}(\hat{\theta})}\]결국 Shrinkage를 적용하면 Bias가 새롭게 발생할 수 있지만, 동시에 Variance를 줄일 수 있다는 것입니다. 그리고 이렇게 감소한 Variance가 증가한 Bias의 제곱보다 충분히 크다면, 최종적으로 MSE를 감소시킬 수 있습니다. 간단하게 예시를 들자면, unbiased estimation 기준으로 $\theta=3$, $\mathrm{Var}(\hat{\theta}) =4$, $\theta_0=2$, $\alpha=0.5$로 가정했을 때, 다음과 같이 전개를 할 수 있습니다:
\[\begin{align*} \mathrm{MSE}(\hat{\theta}) &= \mathrm{Bias}(\hat{\theta})^2+\mathrm{Var}(\hat{\theta}) = 0 + 4 = 4\\ \mathrm{MSE}(\hat{\theta}_{\mathrm{shrink}}) &= (0.5)^2 * (2-3)^2 + (1-0.5)^2 * 4 = 1.25 \end{align*}\] \[\mathbf{\mathrm{MSE}(\hat{\theta}) \geq \mathrm{MSE}(\hat{\theta}_{\mathrm{shrink}})}\]즉, Bias가 발생했음에도 불구하고 Variance가 더 크게 감소했기 때문에 전체 MSE는 오히려 작아지게 됩니다. 물론 이러한 결과가 모든 상황에서 성립하는 것은 아니지만, 그럼에도 불구하고 일부 Bias를 허용하면서 Variance를 더 크게 줄여 전체 estimation error를 감소시킨다는 것이 Shrinkage의 핵심적인 아이디어입니다.
(대표적인 연구로는 James–Stein Estimator [13]이 있습니다.)
그렇다면 다시 본론으로 돌아와서, 사실 저희가 원래 보려고 했던 부분은 SAM과 Shrinkage와의 관계였습니다.
SAM에서 중요하게 보는 부분은 근사를 통한 Hessian의 eigenvalue 값이였습니다.
다만, 현재까지의 shrinkage 개념은 특정 estimation에 대한 조정이였기 때문에 Hessian의 eigenvalue와 직접적인 similarity는 없긴합니다.
그런데 shrinkage의 개념과 eigenvalue와 직접적으로 연결되는 부분이 있는데, 바로 Covariance Shrinkage입니다.
간단하게만 TL;DR로 말씀드리면 covariance matrix에 shrinkage를 적용했을 때 해당 matrix의 eigenvalue를 특정 target으로 조정할 수 있게 됩니다.
따라서 다음으로는 Covariance Shrinkage와 Hessian eigenvalue간에 어떤 연관성이 있는지 한번 살펴보도록 하겠습니다.
Covariance Shrinkage
Covariance Shrinkage는 이름 그대로 covariance matrix에 Shrinkage를 적용한 방법입니다.
여기서 covraince matrix는 symmetric matrix로 데이터 변수들간의 상관관계를 알 수 있고, 이에 대해서 데이터가 각 방향으로 얼만큼 퍼져있는지를 알 수 있습니다.
다만, 실제로는 데이터의 전체 분포를 정확하게 알기 어렵기 떄문에 일반적으로는 추출된 data sample로부터 covariance matrix (denoted as $S$)를 추정합니다.
여기서 또다른 애로사항이 있는데 사실 이 역시 ‘추정’이기 떄문에 오차가 발생할 수 밖에 없을 뿐만 아니라 데이터의 dimension에 비해 sample 수가 충분하지 않다면 추정된 covariance matrix가 기본적으로 불안정해질 수 있습니다.
특히, matrix의 condition number가 커지는 문제가 발생할 수 있습니다.
이 때, 이러한 문제를 해결하기 위해 추정된 covariance matrix를 특정한 target matrix 쪽으로 shrink하는 방법을 사용하곤 합니다. 대표적으로 Ledoit–Wolf [14] 에서 제안한 방법을 살펴보면 다음과 같습니다.
\[\hat{\Sigma}_{\mathrm{shrink}}=(1-\alpha)S+\alpha\mu I\]여기서 $S$는 sample covariance matrix, $I$는 Identity Matrix, $\mu$는 shrinkage target의 크기를 결정하는 scalar입니다.
일반적으로 $\mu=\mathrm{tr}(S)/d$와 같이 eigenvalue의 평균을 사용할 수 있습니다.
이 수식이 앞서 설명한 일반적인 Shrinkage와 굉장히 비슷한 것을 볼 수 있습니다.
차이가 있다면 앞선 설명에서는 단일 scalar 값이 아닌 matrix 전체를 target으로 이동시킨다는 점입니다.
(여기가 핵심!!) 여기서 흥미로운 부분은 이러한 Shrinkage를 eigenvalue 관점에서도 해석할 수 있다는 것입니다.
우선 앞서서 Hessian matrix을 decompose했던 것처럼, sample covariance matrix도 decompose하면:
\[S=Q\Lambda Q^\top\]그리고 이 decomposition된 matrix를 Covariance Shrinkage 수식에 대입하면
\[\hat{\Sigma}_{\mathrm{shrink}}=Q\left((1-\alpha)\Lambda+\alpha\mu I\right)Q^\top\]이 됩니다. 여기서 조금 더 살펴볼 부분은 Shrinkage를 적용하더라도 기존의 eigenvector는 유지되고, eigenvalue만 변화한다는 점입니다. 하나하나 분해해서 보면, 우선 $Q$는 각 eigenvector로 구성된 orthogonal matrix이고, 따라서 $Q^\top Q=I$가 성립하게 됩니다. 따라서, $\mu I$에 대해 다음과 같이 일종의 트릭을 통해 표현할 수 있게됩니다:
\[\mu I=Q(\mu I)Q^\top\]이를 해석해보자면, 기존 covariance matrix와 shrinkage target인 $\mu I$를 동일한 eigenvector basis에서 표현할 수 있다는 의미가 됩니다. 따라서 두 matrix를 합치더라도 eigenvector는 그대로 유지되고, diagonal matrix인 $\Lambda$의 각 eigenvalue에 대해서만 Shrinkage가 적용됩니다. 이를 정리하면 기존 eigenvalue $\lambda_i$는 다음과 같이 변화하게 됩니다.
\[\boxed{\hat{\lambda}_i=(1-\alpha)\lambda_i+\alpha\mu}\]이렇게 됐을 때 결론적으로는 Covariance Shrinkage에서는 각각의 eigenvalue가 특정 target인 $\mu$에 가까워지도록 조정됩니다. 이를 좀 더 풀어서 설명하면, $\mu$보다 큰 eigenvalue는 감소하고, 반대로 $\mu$보다 작은 eigenvalue는 증가하게 됩니다. 따라서 eigenvalue 사이의 차이가 줄어들면서 전체적인 spectrum이 상대적으로 균일해지게 되고, 이를 수식으로 표현하면
\[\hat{\lambda}_i-\hat{\lambda}_j=(1-\alpha)(\lambda_i-\lambda_j)\]이 됩니다.
이 수식을 해석해보면, 기존 eigenvalue 사이의 차이가 $(1-\alpha)$배로 줄어들면서 전체적인 spectral spread가 감소하게 됩니다.
여기서 조금 더 주목할 부분은 Maximum Eigenvalue의 변화입니다.
앞서 설명한 것처럼 $\mu$를 eigenvalue의 평균으로 설정했다면, maximum eigenvalue는 일반적으로 $\mu$보다 크거나 같게 됩니다.
따라서 Shrinkage를 적용했을 때 maximum eigenvalue 역시 다음과 같이 변화하게 됩니다.
즉, 전체적인 spectrum이 균일해지는 과정에서 지나치게 큰 maximum eigenvalue도 함께 억제되는 것입니다.
앞서 살펴본 Hessian의 geometric perspective로 생각하면, 이러한 변화는 anisotropic한 elliptical shape을 상대적으로 isotropic한 spherical shape에 가깝게 만드는 것과 유사합니다.
물론 Covariance Shrinkage의 원래 목적은 단순히 Hessian 조정을 통해 isotropic하게 만드는 그 자체는 아니고, noise가 포함된 covariance estimate의 정확도와 안정성을 개선하는 것이지만, 그 과정에서 나오는 behavior가 Spectral Contraction이라는 geometric property를 SAM과 연결지을 수 있게 됩니다.
다시 SAM의 Hessian perspective 돌아와서, 앞서 Second-order Approximation을 통해 SAM의 worst-case loss가 Hessian의 maximum eigenvalue인 $\lambda_{\max}(H)$와 연결된다는 것을 확인했습니다. SAM은 local minimum 주변에서 maximum eigenvalue가 큰 solution에 더 큰 penalty를 부여하는 것으로 해석할 수 있습니다. 이를 Covariance Shrinkage와 비교해 보면, 두 접근 모두 지나치게 큰 spectral component를 억제한다는 공통적인 geometric intuition을 가지고 있습니다. 앞서 말씀드린대로 “SAM과 Shrinkage는 동일한 기법이다!”를 의미하는 건 절대 아니지만 두 접근 모두 지나치게 큰 spectral component를 억제한다는 공통적인 geometric intuition을 가지고 있습니다.
Conclusion
Wrap-Up
(이제 거의 끝났습니다!!)
이번 포스팅에서는 SAM을 Hessian 관점에서 다시 분석해보고, 이를 Shrinkage Theory와 연결해 색다른 perspective로 분석해봤습니다.
관련하여 다시 정리를 해보면, SAM은 local minimum 주변에서 Hessian의 maximum eigenvalue가 큰 solution에 더 큰 penalty를 부여하는 것으로 해석할 수 있고 수식적으로는 다음과 같이 표현할 수 있습니다:
Shrinkage Theory는 estimation값을 특정 target으로 이동시켜 적절한 trade-off를 찾는 개념으로써, 이를 Covariance matrix 관점에 적용했을 때 동일한 spectral transformation을 Hessian에 적용하여 eigenvalue를 특정 target으로 조정하는 형태로 해석할 수 있게됩니다.
그리고 이를 수식적으로는 다음과 같이 나타낼 수 있습니다:
여기서 $\mu$는 Hessian eigenvalue의 평균을 의미하며, Shrinkage를 적용하면 maximum eigenvalue 역시 $\mu$에 가까워지게 됩니다. 따라서 이를 앞서 정의한 SAM의 worst-case curvature에 적용하면 다음과 같은 관계를 보일 수 있습니다:
\[\boxed{\mathcal{S}_{\rho}(\tilde{H})-\frac{\rho^2}{2}\mu=(1-\alpha)\left(\mathcal{S}_{\rho}(H)-\frac{\rho^2}{2}\mu\right)}\]이 수식의 의미를 보면, Shrinkage를 적용했을 때 평균 curvature를 기준으로 maximum curvature ($\lambda_{max}$)가 얼마나 큰지를 나타내는 값이 $(1-\alpha)$배로 감소하게 되고, 이 관점이 Shrinkage의 Spectral Contraction이 SAM에서 중요하게 다루는 worst-case curvature와도 연결될 수 있다는 점을 보이게 됩니다.
물론 앞서 말씀드린 대로 “SAM과 Shrinkage가 동일한 기법이다!”라는 의미는 절대 아닙니다. Covariance Shrinkage는 eigenvalue를 특정 target으로 직접 이동시키는 반면, SAM은 worst-case loss를 최소화하는 과정에서 dominant curvature가 작은 solution을 선호하도록 학습합니다. 또한 SAM이 모든 eigenvalue를 균일하게 조정하거나 반드시 isotropic한 loss landscape을 만든다고 보장할 수도 없습니다. 다만 그럼에도 불구하고 두 접근 모두 지나치게 큰 spectral component를 억제한다는 공통적인 geometric intuition을 가지고 있습니다. 이러한 관점에서 SAM을 단순히 worst-case loss를 최소화하는 optimization 방법론으로만 보는 것이 아니라, dominant curvature에 대한 일종의 implicit spectral shrinkage와 유사한 효과를 유도하는 방법론으로도 해석해 볼 수 있습니다.
(SAM이 flat하게 만드는 과정에서 spectral shrinkage와 유사한 효과가 부수적으로 나타날 수 있다! 정도로 이해…)
마치며…
오랜만에 블로그 포스팅을 하니까 설명하고 싶은 것도 많고 좀 더 자세하게 적다보니 이래저래 길어진 것 같습니다. 현재 쭉 읽다보면 비문도 많고 오탈자도 좀 있는 것 같은데… 우선은 포스팅 해두고 계속해서 수정해나가도록 하겠습니다.
혹시라도 제가 설명한 개념 중에 틀린 부분이 있다면 언제든 지적해주시고 고견 남겨주시면 십분 반영하도록 하겠습니다!!😀😀
긴 글 읽어주셔서 감사합니다!!
Reference
[1] Zhang, Chiyuan, et al. “Understanding deep learning requires rethinking generalization.” ICLR’17 [링크]
[2] Nakkiran, Preetum, et al. “Deep double descent: Where bigger models and more data hurt.” ICLR’20 [링크]
[3] Foret, Pierre, et al. “Sharpness-aware minimization for efficiently improving generalization.” ICLR’21 [링크]
[4] Li, Hao, et al. “Visualizing the loss landscape of neural nets.” NeurIPS’18 [링크]
[5] Kwon, Jungmin, et al. “ASAM: Adaptive sharpness-aware minimization for scale-invariant learning of deep neural networks.” ICML’21 [링크]
[6] Zhuang, Juntang, et al. “Surrogate gap minimization improves sharpness-aware training.” ICLR’22 [링크]
[7] Du, Jiawei, et al. “Efficient sharpness-aware minimization for improved training of neural networks.” ICLR’22 [링크]
[8] Möllenhoff, Thomas, and Mohammad Emtiyaz Khan. “Sam as an optimal relaxation of bayes.” ICLR’23 [링크]
[9] Liu, Yong, et al. “Towards efficient and scalable sharpness-aware minimization.” CVPR’22 [링크]
[10] Lee, Hyun Kyu, and Sung Whan Yoon. “Flat reward in policy parameter space implies robust reinforcement learning.” ICLR’25 [링크]
[11] Lee, Taehwan, et al. “Understanding flatness in generative models: Its role and benefits.” ICCV’25 [링크]
[12] Geman, Stuart, Elie Bienenstock, and René Doursat. “Neural networks and the bias/variance dilemma.” Neural computation 1992 Vol.4 Issue 1 [링크]
[13] James, William, and Charles Stein. “Estimation with quadratic loss.” Proceedings of the Fourth Berkeley Symposium on Mathematical Statistics and Probability (1961) [링크]
[14] Ledoit, Olivier, and Michael Wolf. “A well-conditioned estimator for large-dimensional covariance matrices.” JMVA’04 (Journal of Multivariate Analysis) [링크]